
Google DeepMind VLA 模型,赋予机器人全身智能与精细灵巧操作
Gemini Robotics 2 是 Google DeepMind 发布的视觉-语言-动作(VLA)模型,将视觉与语言输入转换为机器人运动控制,可在双手机器人上数小时内完成适配,并扩展到复杂人形机器人的全身智能控制,实现精细灵巧操作与智能体推理。
安全检测工具协议集成关键点检测机器人操作具身导航
近7天 4 动态
Capability Timeline
理解或预测世界状态,用于机器人、仿真或具身智能。
Google DeepMind VLA 模型,赋予机器人全身智能与精细灵巧操作
Gemini Robotics 2 是 Google DeepMind 发布的视觉-语言-动作(VLA)模型,将视觉与语言输入转换为机器人运动控制,可在双手机器人上数小时内完成适配,并扩展到复杂人形机器人的全身智能控制,实现精细灵巧操作与智能体推理。
全球 AI 视频生成平台,提供实时世界模型与游戏引擎
PixVerse 是全球 AI 视频生成平台,提供文生视频、图生视频、视频编辑、口型同步、音频生成等能力。旗舰模型 V6 支持电影级镜头控制与角色表演。2026 年 1 月发布 R1 实时世界模型,将视频转变为可交互的连续流,并推出 PixVerse Game Engine 将实时世界模型应用于游戏创作,玩家可用自然语言交互,世界实时响应。平台还提供 API、智能体、营销中心、画布等企业级工作流工具。
Black Forest Labs 的多模态基础模型,统一图像、视频、音频生成与机器人动作预测
FLUX 3 是 Black Forest Labs 发布的多模态基础模型,基于 Self-Flow 方法在单一架构中联合学习图像、视频与音频,同一组权重即可输出图像、视频、带原生音频的视频以及机器人动作预测。FLUX 3 Video 可单次生成长达 20 秒、带原生音频的视频。模型提供 API、Playground 在线试用与开放权重部署,支持按需付费与商业授权,面向内容创作与物理 AI 场景。
银河通用具身多模态大模型通用机器人
Galbot 银河通用是全球具身智能机器人公司,致力于具身多模态大模型通用机器人研发,服务千行百业、千家万户。团队发布全球首个面向具身智能大模型的测试时后训练框架 WAM-TTT,基于预训练世界动作模型(WAM),仅凭未标注人类视频即可在部署阶段适配新场景,实现机器人部署后的持续学习与跨场景泛化。
谷歌旗舰多模态AI模型,擅长编程、网络安全与超长任务推理
Gemini 4 Argon 是 Google DeepMind 推出的旗舰多模态 AI 模型,面向软件工程、金融、法律与网络安全等领域的长周期复杂任务。它具备跨学科推理、代码编写与多步骤任务持续能力,可自主发现、验证并修补关键软件漏洞,在提示注入防护上为迄今最强。模型支持最长达约一百万词元的输出与超长上下文,并具备视频等多模态理解能力。目前谷歌先向受信任的网络安全合作伙伴小范围开放,完成更多测试后将优先面向付费订阅用户扩大开放。
小米380亿参数具身智能世界基础模型
Xiaomi-Robotics-U0是小米推出的380亿参数多模态自回归世界基础模型,专为具身智能设计。在单一框架内统一文生图、图像编辑、多视角具身场景生成、具身迁移和具身视频生成五项任务,支持跨多种机器人形态的高质量多视角场景生成,并实现结构化可控的具身迁移编辑,同时保持多视角一致性与交互动态。

高德3D原生城市世界模型,文字或卫星图生成可漫游三维地球城市
ABot-Earth 是高德推出的3D原生城市世界模型,基于海量时空数据训练,端到端生成3DGS(三维高斯泼溅)格式城市场景。输入卫星图像或文字描述即可快速生成公里级照片级三维空间,支持从星球到城市、再到街景地标的全尺寸连续生成与自由漫游、实时交互。体验官网提供地球、月球、火星及海内外多座城市的真实级三维空间探索,文字创作1平方公里地块功能正内测申请中。
Wiz 自主 AI 智能体漏洞挖掘系统
Atlas 是 Wiz Research 团队打造的自主 AI 漏洞挖掘系统,由多个 AI 智能体分工协作,分别负责理解代码库、提出漏洞假设、相互验证质疑并完成确认与报告。它以代码属性图分析程序结构、自动搭建测试环境生成可用攻击验证漏洞,实现可大规模运行的 AI SAST 代码安全扫描,在 CyberGym 基准上取得 90.9% 成绩位列第一,已在多个高强度审计的开源项目中发现超 200 个未知漏洞。

百万小时人类视频预训练的世界动作模型
Dyna-2 是 DYNA Robotics 发布的世界动作模型(world-action model),在超过 100 万小时人类第一人称视频上完成预训练,可预测动作并生成视频片段。官方研究页显示其在留出人类数据与零样本机器人数据上均呈现单调提升的规模定律,并在两种机器人本体、39 项机器人任务上验证了人类到机器人的迁移能力。
实时可导航 AI 世界模型,已上线 Reactor
Happy Oyster 是一款实时世界模型,用户可进入可实时导航的 AI 生成世界,探索精选世界或亲自执导、实时塑造故事走向。产品已正式上线 Reactor 平台,并提供 API 供开发者调用,适用于交互式世界探索与实时内容生成场景。

基于JEPA架构的超级马里奥世界模型
LeMario 是一个从零实现的动作条件联合嵌入预测架构(JEPA)世界模型,在《超级马里奥兄弟》上训练。模型从游戏画面和手柄输入中学习短期潜在动态,使用 AdaLN-Zero 将动作注入六层 Transformer 预测器,并通过交叉熵方法(CEM)在潜在空间进行无奖励规划。项目在 737134 帧、280 个回合、32 个关卡上训练,验证了短时程动作条件动态预测的有效性,同时揭示了预测状态与控制状态之间的根本差异。

开源实时交互世界模型,单卡生成720p可玩世界
LingBot-World 2.0(又名 LingBot-World-Infinity)是蚂蚁灵波(Robbyant)开源的交互式世界模型,含14B主模型与1.3B轻量版。基于因果预训练、MoBA注意力掩码与一致性/DMD蒸馏,可实时生成小时级连贯、可探索可交互的720p/60fps世界,支持攻击、射箭、施法、射击等动作与文本事件,并内置飞行员/导演双智能体。1.3B版本面向消费级单卡实现本地实时生成,权重以CC BY-NC-SA 4.0在HuggingFace与ModelScope开放。
面壁智能端侧大模型系列,小而强大
MiniCPM是面壁智能(OpenBMB)自主研发的端侧大模型系列,包括文本基座模型MiniCPM5-1B、稀疏注意力模型MiniCPM-SALA等。专为端侧部署和资源受限场景设计,支持本地助手、编码代理、工具调用和长上下文推理。
生数科技自进化通用世界模型,驱动高自由度灵巧手操作
Motus2 是生数科技(GensPI)与清华大学联合发布的自进化通用世界模型,面向机器人灵巧操作。单个共享参数模型同时提供策略、模拟器与评估器三个接口,把行动、后果预测与结果评估耦合成闭环,通过 Best-of-N 规划与基于模型的强化学习(MBRL)持续改进策略。模型基于约13万小时人类第一视角数据分层预训练并完成机器人域适配,内置触觉专家与工作记忆,已部署在 Sharpa Wave、WUJI Hand 2 等灵巧手平台。
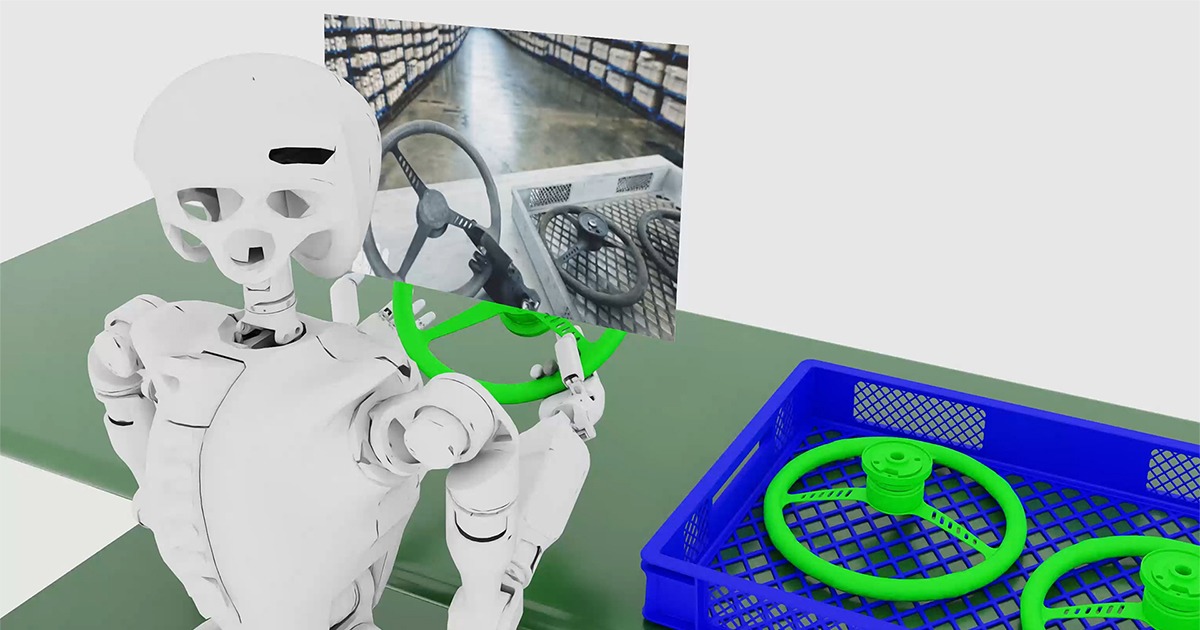
英伟达开源物理AI世界基础模型平台
NVIDIA Cosmos 是一个开源的物理 AI 基础世界模型平台,包含 Cosmos 3 基础版及 Cosmos 3 Edge 等模型。它可作为视觉语言模型对复杂真实场景中的物体、交互和意图进行推理,支持质量检测、公共安全、交通监控、物流和自动驾驶等实时告警与密集描述。同时可加速机器人策略学习,作为世界动作模型骨干适配特定任务和领域行为;还可作为可控的物理世界模拟器预测多种方案并闭环评估结果;并支持从文本、图像、视频、环境声音和动作输入生成无限合理的合成视频数据,用于训练物理 AI。
基于互联网视频预训练的目标条件强化学习模型
Pantograph 推出的首个目标条件强化学习模型,通过互联网规模视频预训练学习目标导向行为。Pan-4B 拥有40亿参数,在约50万小时 Minecraft 视频上预训练,再经约2000小时承包商轨迹后训练。模型能根据目标图像指令在 Minecraft 中战斗、探索、建造和完成平台跳跃任务,并可泛化到未见过的环境。

基于ROS2的开源通用具身Agent中间层底座框架与平台
PhanthyMotus是由范式推出的下一代开源具身智能Agent框架与平台,基于ROS2构建,通过可插拔的多模型框架灵活集成World Models、LLM与VLM,并提供长时记忆、动态技能库与持续Agent循环的全栈架构。它统一传感器与驱动器接口,实现多传感器融合与精准电机控制,硬件可扩展覆盖人形、四足、机械臂、轮式平台与无人机全形态,支持远程调试与代码复用,帮助开发者零门槛构建可感知、思考、自主行动的具身智能体。
PhysBrain 1.5 是深度机智(DeepCybo)发布的开源物理基座模型,基于 Qwen3-VL,在单一自回归主干下以离散 token 统一具身理解、动作生成与未来状态预测。模型可理解视觉空间场景、生成跨机器人平台的末端执行器动作轨迹,并预测未来一步的 RGB 图像、深度图与机器人掩码。提供 2B 与 8B 两档权重、技术报告与评测工具包,在 28 项具身基准上以 72.5 分位列开源第一。
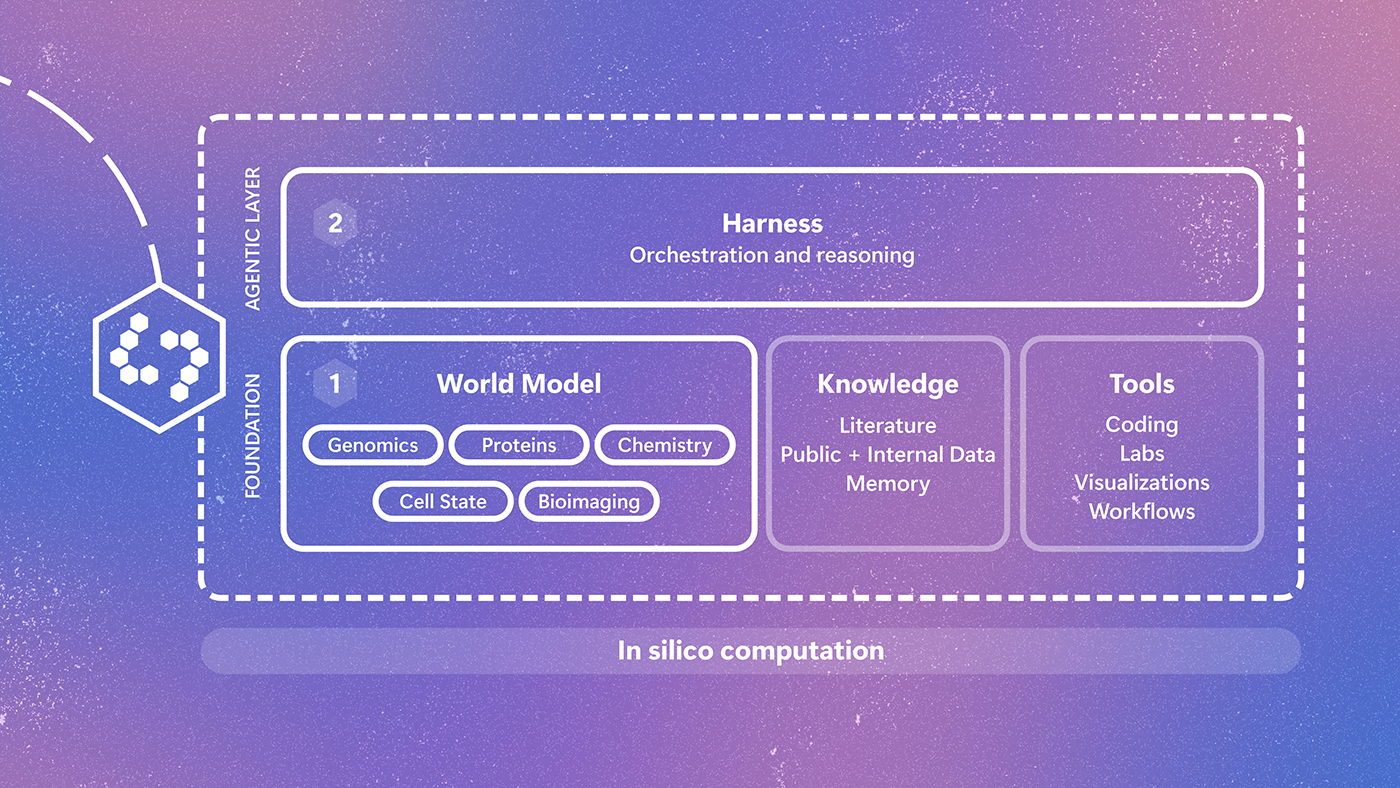
微软研究院推出的生物学多模态世界模型,衔接计算建模与湿实验以加速药物发现
Project Quine 是微软研究院联合哈佛大学与麻省理工学院博德研究所推出的实验性多模态 AI 研究系统,将覆盖基因组学、蛋白质、化学、细胞状态与生物成像的生物学世界模型,与连接科学工具、文献、湿实验和研究人员的交互式推理框架相结合,可预测、排序候选化合物并经湿实验验证。系统目前仅限科研用途、不可临床使用,已启动 Quine Fellows 申请,未来计划通过 Microsoft Discovery 逐步扩大商业化开放。
RLinf 是由无问芯穹联合清华大学等共同研发的全球首个面向具身智能持续进化的大规模强化学习基础设施项目。它提供从数据采集、数据管理、监督微调(SFT)、强化学习(RL)、模型评测到真机部署的一站式开发平台,支持多种具身模型(VLA模型、世界模型)、仿真器(Genesis、Polaris、RoboVerse、IsaacLab)、真机平台(Franka、GimArm、DOS-W1)以及异构计算硬件(昇腾、AMD ROCm、Musa),实现从仿真训练到真实机器人在线学习的统一开发闭环。
Runway 首个界面世界模型,实时逐帧生成应用与网站交互界面
Solaris 是 Runway 推出的 Interface World Models(界面世界模型)系列的首个模型。它以操作系统直接渲染应用与网站界面为核心思路,不再需要把视觉设计转换为中间代码表示,而是由单个世界模型实时逐帧合成界面与响应,图像本身即交互层,支持视觉化、动态响应与开放式交互。该模型还可用于在持续变化的界面环境中训练智能体,使其适应不断变化的布局而非局限于特定训练环境。面向 UI 设计、网页与应用构建及智能体研究等场景。
文远知行自研物理AI认知基础大模型
WeRide WITT 是文远知行 WeRide 自研的物理 AI 认知基础大模型,全称 World Intelligence Toward Truth。基于视觉语言大模型(VLM)能力,WITT 引入"最小物理事实单元"概念,打通视频、图像、文本等多模态信息,将连续变化的真实场景拆解为可被识别和验证的事实单元。WITT 具备事实提取、事实推理、事实验证、事实编排四大核心能力,内置视频数据引擎支持关键词或自然语言检索海量视频数据,与文远知行世界模型 WeRide GENESIS 协同训练自动驾驶车端模型。
空间智能世界模型与3D世界生成平台
World Labs 是李飞飞创办的空间智能公司,构建能够感知、生成、推理并与三维世界交互的前沿世界模型。首款产品 Marble 可从文字、图片、视频或 360 全景生成空间一致、高保真且持久的可漫游 3D 世界,支持交互式编辑、世界扩展合并,并导出多种 2D/3D 格式接入既有流程;同时提供 World API 供应用调用世界生成能力。
小米具身基座模型,基于大规模无本体预训练实现开箱即用机器人操作
Xiaomi-Robotics-1 是小米技术发布的具身基座模型,结合10万小时无本体(UMI)真实世界操作数据预训练与约10000小时跨本体后训练,可根据自然语言指令直接执行移动操作任务。在RoboCasa365基准平均成功率57.4%,在RoboDojo仿真评测登顶Leaderboard。