APX(Agent Project eXecutable)是 APC 协议的参考实现,由本地守护进程、CLI 与网页管理台组成,让 AI 智能体基于同一份可移植项目上下文运行。它可把请求路由到 Claude Code、Codex、OpenCode 或 Aider 并支持逐级回退,智能体记忆与会话以纯文件保存在 .apc/ 上下文中,无需数据库,并提供会话、消息日志与项目管理命令。
Capability Timeline
本地模型推理
支持下载模型到本地设备,完全离线执行智能体或模型推理,无需云 API
相关工具
29docker-agent 是 Docker 开源的 AI 智能体构建器与运行时,以 docker CLI 插件运行,用声明式 YAML 定义智能体。支持多智能体任务委派,内置 think、todo、memory 与 RAG 检索;可接入任意 MCP 服务器,兼容 OpenAI、Anthropic、Gemini、xAI 及 Docker Model Runner 本地模型;智能体可打包为 OCI 镜像分发,随 Docker Desktop 4.63+ 预装。
FLUX 3 是 Black Forest Labs 发布的多模态基础模型,基于 Self-Flow 方法在单一架构中联合学习图像、视频与音频,同一组权重即可输出图像、视频、带原生音频的视频以及机器人动作预测。FLUX 3 Video 可单次生成长达 20 秒、带原生音频的视频。模型提供 API、Playground 在线试用与开放权重部署,支持按需付费与商业授权,面向内容创作与物理 AI 场景。
Hermes Agent (Nous Research) 是开源(MIT)自进化 AI 智能体,内置学习回路:从经验中自动创建技能、持续改进、留存知识、检索自身历史对话,并跨会话构建更深的用户模型。可在低价 VPS、GPU 集群或 serverless 运行,并提供 Hermes Desktop 桌面端。近期 Bot Mode 将单一对话列表替换为一组命名机器人,每机器人拥有独立聊天、记忆、技能、固定模型与持久化 Agent Inbox,可通过 @提及 交接工作。
Perplexity Computer 是 Perplexity 官方推出的智能体产品,可将任务拆分给多个子代理(subagents)执行,并支持指定编排模型(orchestrator model)统一调度这些子代理;同时提供定时自动化(scheduled automations)能力,按计划自动运行任务。据官方公告,GPT 5.6 Terra 已成为所有 Computer 子代理的默认模型,Luna 作为定时自动化的主要模型,Terra 亦可作为编排模型使用。
Altar-1 是 Aikido Security 发布的首个开放权重网络安全模型,由 Z.AI 的 753B MoE 模型 GLM-5.3 经 AWQ INT4 量化与 Cerebras REAP 专家剪枝(保留 168/256 专家)压缩至 328GB,无需再训练。权重在 Hugging Face 公开,可通过 vLLM 在 4× H200(Hopper)单节点自行部署,支持 128k 上下文,面向客户自控基础设施与气隙网络中的自动化渗透测试场景。
Ante 是 Antigma Labs 推出的自包含终端编码代理,以约 15MB 的单个 Rust 二进制文件分发,零运行时依赖。它以客户端-守护进程架构运行结构化回合循环(提示、工具调用、确认、执行),支持交互式 TUI、无头 CLI 与 ante serve 长驻服务,可自带 API Key 在 12 个以上模型供应商或本地模型间自由切换,并提供多智能体协同、自定义技能、子智能体、MCP 与跨会话持久记忆。
Bonsai 1.7B 是 PrismML 基于 Qwen3-1.7B 推出的 1.58-bit 三元(Ternary)开源语言模型,采用 GGUF Q2_0 量化格式,打包体积仅 436 MiB,约为 FP16 的 1/7.5,支持 32K 上下文。配合 PrismML 定制版 llama.cpp 可在 CPU(NEON)与 Apple Metal 上本地推理,采用 Apache 2.0 许可。
colibri 是开源纯 C 本地大模型推理引擎,无需 GPU 即可在普通电脑内存与磁盘上运行数千亿参数 MoE 开源模型。内置 GLM、DeepSeek、Qwen、Kimi、MiMo 等 13 个引擎,支持本地对话、OpenAI 兼容 API 服务、工具调用、图像理解与 Qwen-Image 文本生成图像,并提供 System One 决策 API。v2.0.0 新增 Vulkan GPU 加速、双 GPU 专家分层与最多 16 路并发会话。
Embabel 是面向 JVM 的智能体(Agentic AI)开发框架,由 Spring 之父 Rod Johnson 等人共同打造。Java 与 Kotlin 开发者可用 @Action 方法把智能体定义为带类型的领域组件,由框架规划从当前状态到目标的执行步骤,并在过程中调用模型、工具或其它智能体作为子流程;同时支持用 Embabel 构建交互式 MCP 工具,把 AI 能力嵌入既有企业级 JVM 应用。
Flash 是一款完全运行在用户本机的 AI 编程智能体,通过 Ollama 调用本地模型,无需 API Key、订阅或上传代码。0.5.5 版本新增浏览器界面(flash --web),支持流式回复、折叠式工具调用、彩色 diff 与键盘权限确认、项目管理、全局聊天搜索、生成文件侧栏及快捷键面板;通过 --lan 可凭终端二维码和每次启动随机生成的令牌从手机安全访问。智能体还能在任务结束后异步复盘,自动沉淀可复用的 Skills 与写入系统提示的 Memory,并以精确文本片段方式修改文件。
GLiNER2.5 是 Fastino 发布的 schema 驱动的信息抽取与文本分类模型,用边界预测取代跨度枚举,使实体跨度不再随长度消耗算力,推理随文档长度线性扩展。模型原生支持最长4096词长上下文抽取与分类、任意长度实体跨度、实体与关系联合抽取以构建知识图谱、约束分类以及带跨度属性的富抽取上下文,并提供原生分块与字符偏移重映射的批处理长文档接口。官方在 Apache 2.0 许可下发布 base(0.2B)、multi(0.3B)、small(74M) 三个可本地运行模型版本。
GLM-5.3-Flash 是智谱 GLM-5 系列首个原生多模态开源模型,总参 320B、激活参仅 18B,首次采用稀疏+线性注意力混合架构以降低成本服务长上下文。视觉能力原生融入编码循环,可观察界面与渲染结果持续测试改进,并扩展至 Office、金融研究与专业文档工作流,自研拆解目标、调用工具并交付 PPTX/PDF/DOCX/XLSX 成品,支持 1M token 上下文,可经 Z.ai 与 BigModel 调用或本地部署。
Google Antigravity 是谷歌推出的智能体开发平台,让用户在智能体优先时代构建应用。包含 Antigravity 2.0 工作台(并行管理多个本地智能体、按项目分组对话、跨工作区操作并定时自动化任务)、CLI(终端运行自主编码智能体、执行 shell 命令、管理后台子智能体)、SDK(少量 Python 代码快速原型化自定义智能体并运行评估)以及功能完备的智能体 IDE,面向开发者、企业和业余编码者。
Janus 是 Go 编写的单二进制本地 LLM 服务器,通过 llama.cpp 的 Vulkan 后端在 AMD/Intel/NVIDIA GPU 或 CPU 上运行 .gguf 模型,无需 Python、Docker 或 Ollama。它暴露 OpenAI 兼容接口,支持流式输出、模型热切换与思考模型,可接入 Cursor、Cline 等客户端,支持 Windows、Linux、macOS。
Laya 模型的 Core ML/ANE 转换与本地运行 PyPI 包
laya-coreml 是将 Laya 模型适配到 Apple Core ML 与神经引擎(ANE)的 Python 包,提供模型图签名、权重与导出能力校验及本地转换/运行时检查。v0.2.0 同步上游 0.3.23 的提示词与结果修复,新增问题定义校验、Unicode 结构化指令保留、自定义显示标签、会话 token 保留策略、截断诊断、answer_confidence 字段与 checkpoint 温度钳制,Core ML/ANE 图签名与权重保持不变。
Modular(MAX Platform)是一套从内核到云端的统一 AI 推理软件栈,让同一模型、同一代码库可在 NVIDIA、AMD、Intel、ARM、高通、苹果芯片以及 TPU、Trainium 等 GPU、CPU、ASIC 上运行,支持从云端到边缘的部署与动态硬件调度,并用 Mojo 为新架构编写自定义内核。高通于 2026 年完成收购,2026 骁龙峰会宣布该平台将进入骁龙手机、PC、汽车及可穿戴等完整产品组合,加速本地 AI 落地。
Nemotron 3 Diarization 是 NVIDIA 在 Hugging Face 发布的开放权重说话人分离模型,参数量约 1 亿,用于判断对话中“谁在何时说话”。单一检查点同时支持离线录音与实时流式推理,最多追踪 8 位说话者并处理多人语音重叠,输入缓冲延迟最低可配至 80ms(推荐最低 0.32s)。模型采用 OpenMDW License 1.1,允许商用,可通过 NVIDIA NeMo Speech 或 NeMo-Speech.cpp 在 Linux 的 NVIDIA GPU 上本地部署。
NIKA Desktop 是基于 SwiftUI 与 llama.cpp 构建的 macOS 原生开源 AI 助手,需 Apple Silicon Mac(macOS 26+)。用户可下载内置模型或导入兼容 GGUF 离线运行本地 LLM,本地聊天无需注册账号;支持附加文本文档与 PDF 进行文档问答,对话历史保存在本地。通过 Telegram 登录可选接入 NIKA 云端,使用云端代理、工具与集成、自定义助手以及 WebRTC 实时语音;云端后端不含在本仓库内,当前仅提供源码构建,暂无公证安装包。
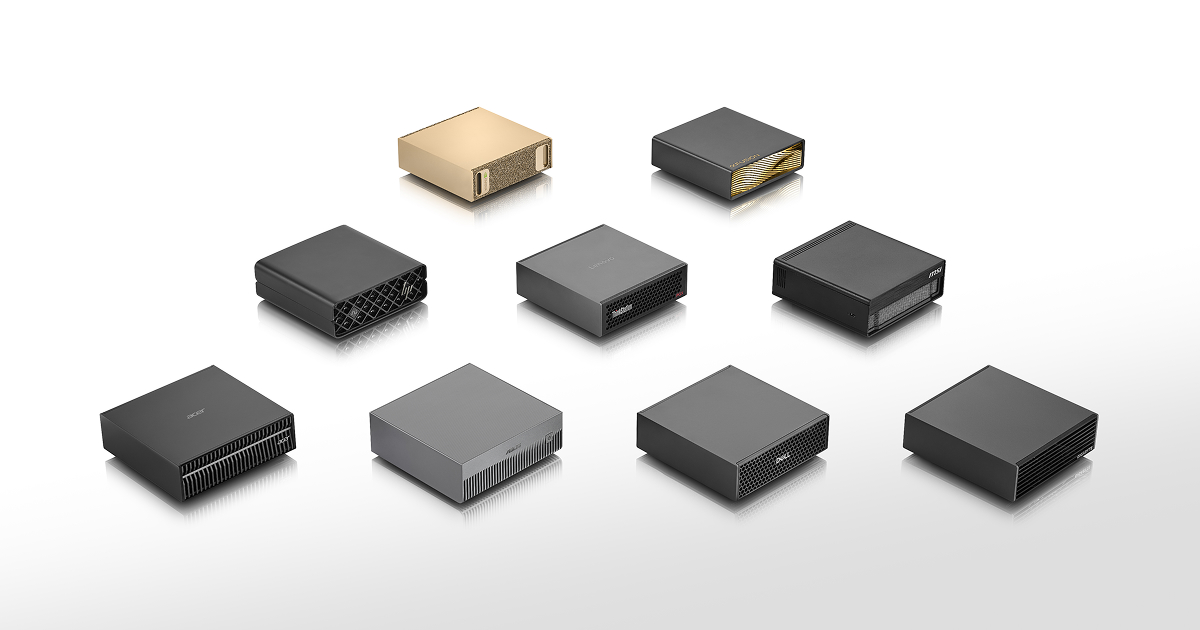
NVIDIA DGX Spark 是搭载 GB10 Grace Blackwell 超级芯片的桌面 AI 计算机,FP4 精度下提供最高 1 PFLOP AI 算力,配备 64GB 或 128GB 统一内存,可在本地运行自主智能体与大模型、减少云端 token 依赖。支持通过 ConnectX 网络连接最多四台设备以运行更大模型与多智能体工作流,并内置含 NVIDIA NIM 在内的完整 AI 软件栈。
OpenFlowKit 是一款免费开源(MIT 许可)的本地优先架构图绘制画布,无需账号,直接在浏览器使用。支持手绘,或用自有 DSL、Mermaid、D2、Structurizr 以代码绘图;可接入 10 家 AI 提供商或本地模型生成与修改图表;通过 MCP 服务器让 Claude Code、Cursor 等编码代理实时编辑画布;粘贴 GitHub 仓库即可自动生成架构图,每条连线都引用到具体文件与代码行;CLI 可在本地映射私有仓库,并支持在 CI 中检查图表漂移,导出 PNG/SVG/PDF 及动画。
OpenScience 是 Synthetic Sciences(YC W26)推出的开源 AI 科研工作台(AI co-scientist),采用 Apache 2.0 许可,可本地运行。用户给出研究目标后,它会自动检索阅读文献、编写并运行代码、执行实验、撰写发现报告,每一步均有记录。内置免费模型,也可接入 Claude、GPT、Gemini 等任意厂商模型;新版推出重新设计的研究 IDE 及聚合 30+ 模型的 OpenScience Ace。
Pulse Local 是一款 Mac(Apple Silicon)个人预算应用:交易从银行 CSV 导入,支持预算计划、分类、规则、结转、拆分、现金流与预测。其 AI 模型(调优小模型,约 2.9GB)完全在本机运行,首次下载后可离线使用;支出问答由两个模型各自读取、结果一致才展示金额,不一致时明确表示不确定,AI 回答均带标注。应用本体自选金额、全部功能免费,可选 Plaid 银行同步(Connected 模式)需付费 Sync Pass,29 美元/年。
Soup 是开源的大模型微调与后训练命令行工具,用一份 YAML 即可自动生成训练配置,涵盖 SFT 与 DPO、ORPO、SimPO、KTO 等对齐方法。其 Layer Streaming 把冻结底座放在内存或 NVMe 中逐层送入显存并量化为 NF4,使 Llama-3.1-8B 可在 4 GB 显存笔记本 GPU 上微调,并可与 HuggingFace、Ollama、vLLM 等生态对接。