
阿里云高性能Serverless Spark数据湖仓服务
阿里云EMR Serverless Spark是面向数据与AI场景的高性能湖仓服务,基于开源Spark生态构建,提供端到端数据平台服务,包括作业开发、调试、调度和运维。内置Fusion Engine性能比开源Spark提升300%,支持存算分离与按量付费,显著简化数据处理和模型训练流程。
目标检测数据分析图像理解自动化工作流
近7天 2 动态
Capability Timeline
识别图像中的目标并定位其位置或边界。
阿里云高性能Serverless Spark数据湖仓服务
阿里云EMR Serverless Spark是面向数据与AI场景的高性能湖仓服务,基于开源Spark生态构建,提供端到端数据平台服务,包括作业开发、调试、调度和运维。内置Fusion Engine性能比开源Spark提升300%,支持存算分离与按量付费,显著简化数据处理和模型训练流程。

谷歌旗舰多模态AI模型,擅长编程、网络安全与超长任务推理
Gemini 4 Argon 是 Google DeepMind 推出的旗舰多模态 AI 模型,面向软件工程、金融、法律与网络安全等领域的长周期复杂任务。它具备跨学科推理、代码编写与多步骤任务持续能力,可自主发现、验证并修补关键软件漏洞,在提示注入防护上为迄今最强。模型支持最长达约一百万词元的输出与超长上下文,并具备视频等多模态理解能力。目前谷歌先向受信任的网络安全合作伙伴小范围开放,完成更多测试后将优先面向付费订阅用户扩大开放。
百度与IFAW联合推出的濒危物种图像识别平台,助力打击野生动物非法贸易
AI Guardian 是百度与 IFAW(国际爱护动物基金会)联合推出的濒危物种识别平台,由 ERNIE 大模型驱动。平台基于 IFAW 提供的约10万张野生动物图像训练,用户上传图片即可快速分类识别目标物种及其制品并给出置信度分数,并已整合进 IFAW 的非法贸易数据库用于自动筛查网络图片。项目自2020年起将 AI 用于野生动物保护,已累计帮助删除超过18,000条涉非法野生动物贸易的商品信息。

可在端侧本地运行的视觉语言模型,支持 OCR 与工具调用
LFM2.5-VL-3B 是 Liquid AI 面向端侧部署的视觉语言模型,以 LFM2.5-2.6B 为语言骨干并搭配 SigLIP2 NaFlex 400M 视觉编码器,支持 32768 token 上下文与 16 种语言。可处理文本与图像输入,具备整页 OCR 带版面标注、自然语言指代的目标定位与检测、多图推理、屏幕 UI 理解与函数调用能力,并提供 GGUF、ONNX、MLX 量化版本用于 CPU、移动与 Apple Silicon 推理。
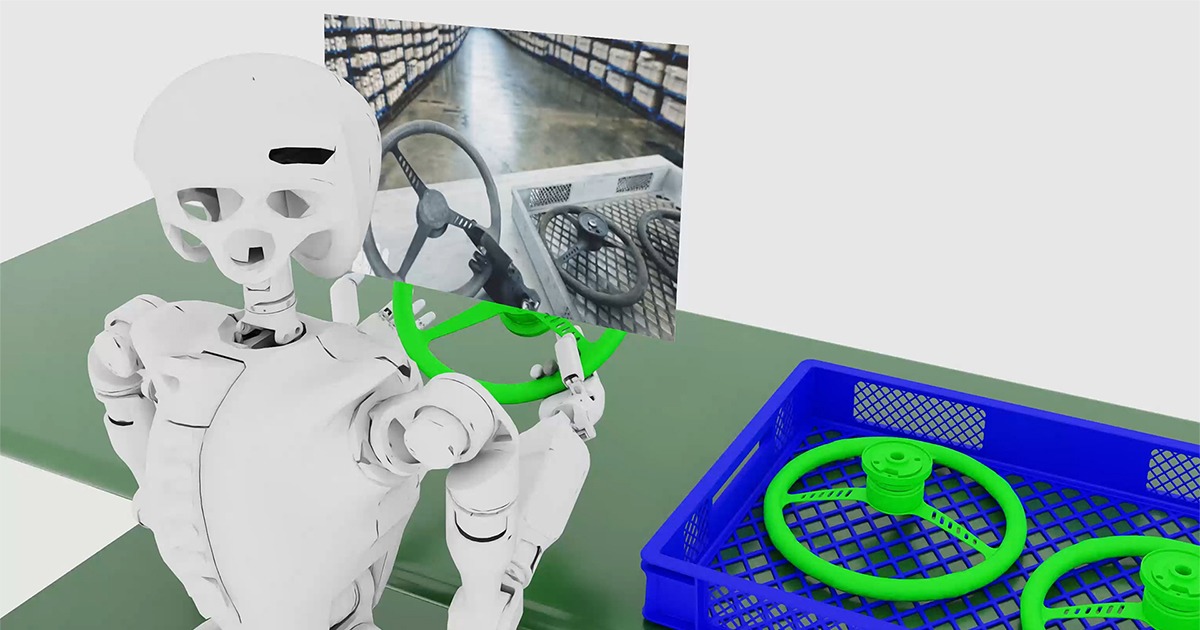
英伟达开源物理AI世界基础模型平台
NVIDIA Cosmos 是一个开源的物理 AI 基础世界模型平台,包含 Cosmos 3 基础版及 Cosmos 3 Edge 等模型。它可作为视觉语言模型对复杂真实场景中的物体、交互和意图进行推理,支持质量检测、公共安全、交通监控、物流和自动驾驶等实时告警与密集描述。同时可加速机器人策略学习,作为世界动作模型骨干适配特定任务和领域行为;还可作为可控的物理世界模拟器预测多种方案并闭环评估结果;并支持从文本、图像、视频、环境声音和动作输入生成无限合理的合成视频数据,用于训练物理 AI。

面向物理智能体的具身视觉推理模型,可输出点框多边形与视频片段
Perceptron 是面向物理智能体的具身视觉推理模型,为真实世界连续视频流提供感知与推理层。模型接受文本、图像、视频输入,能以点、边界框、多边形和视频片段配合文本作答,支持跨时序推理、视频片段时间码定位、单样本目标检索、手势关键点估计与密集场景计数。开发者可通过 API 调用,企业可申请权重商业许可;Mk1.5 版本已于 2026 年 9 月 25 日上线 OpenRouter。
统一多模态视觉生成模型,以单一架构覆盖目标检测、分割、深度预测与多视角3D重建等计算机视觉任务
SenseNova-Vision是一款将计算机视觉统一为多模态生成的开源模型。该工具通过自然语言指令和可选视觉提示来定义任务与输出格式,以原生文本、图像或混合形式响应,可完成目标检测、图像分割、深度预测、表面法线估计、OCR识别、关键点检测、推理分割、交互式分割及多视角3D重建等任务。模型无需任务专用预测头或架构分支,通过统一的多模态生成空间同时覆盖结构化视觉理解、密集几何预测与多视角视觉几何,并提供可解析输出以适配标准评测基准